مینیمکس، شرکت چینی توسعهدهنده مدلهای زبانی بزرگ، از نسل تازهی مدل خود بهنام M3.1 Flash رونمایی کرد. این نسخه بر اساس اعلام سازنده در وظایف کلیدی هوش مصنوعی عاملی (Agentic AI) به سطح مدلهای پیشرو میرسد و در عین حال هزینهی API آن به یکسوم و سرعت پردازش به سه برابر مدل M3 رسیده است.
برآورد کارایی در بنچمارکهای رسمی
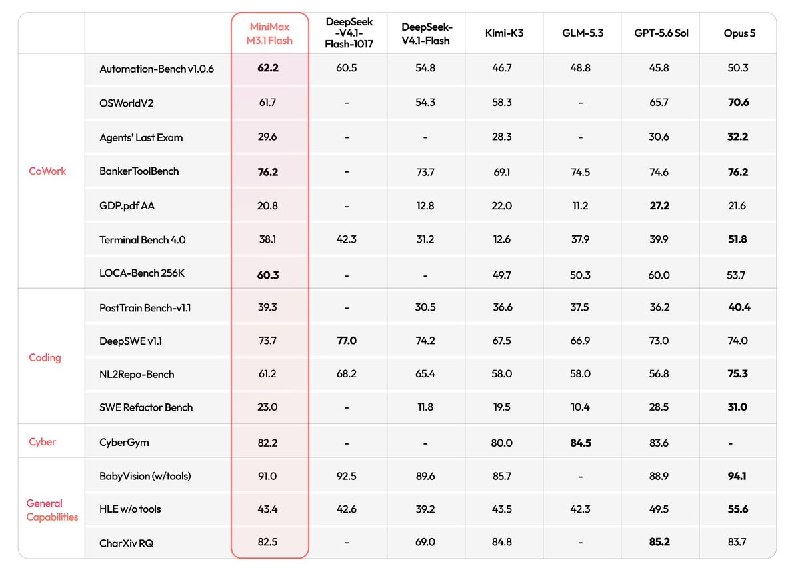
در آزمونهای اعلامشده، M3.1 Flash در حوزهی Cowork نمرهی ۶۲ درصد در Automation-Bench و ۳۰ درصد در ALE کسب کرده است. در بخش کدنویسی، عملکرد این مدل به ۷۴ درصد در DeepSWE رسیده و در استدلال بصری نیز ۹۱ درصد در BabyVision ثبت شده است. این ارقام نشان میدهد که با حفظ دقت، سرعت و هزینهی اجرا بهطور چشمگیری بهبود یافته است.
قیمتگذاری و دسترسی
قیمت API این مدل بهصورت ثابت ۰٫۱۵ دلار برای هر یک میلیون توکن ورودی و ۰٫۶۰ دلار برای هر یک میلیون توکن خروجی تعیین شده است. هزینهی خواندن از کش نیز ۰٫۰۱۵ دلار به ازای هر یک میلیون توکن است. این سطح از قیمتگذاری، مینیمکس را در گروه مدلهای مقرونبهصرفه در بازار جهانی هوش مصنوعی جای میدهد.
وزنها و نسخهی Space Bunny
وزنهای کامل مدل M3.1 Flash قرار است در ۲۳ اکتبر منتشر شوند. بهعلاوه، نسخهی Space Bunny که پیشتر با پردازش بیش از ۲۰۰ تریلیون توکن صدر جدولهای جهانی را در دست داشت، در واقع نسخهی اولیهی همین M3.1 Flash بوده است.
این انتشار، رقابت در حوزهی مدلهای زبانی بزرگ را در سطح جهانی تشدید کرده و نشان میدهد که فناوری هوش مصنوعی عاملی در مسیر دسترسیپذیری و مقیاسپذیری قرار دارد. برای کاربران و توسعهدهندگان فارسیزبان، کاهش هزینه و افزایش سرعت پردازش میتواند امکان پیادهسازی راهحلهای هوشمند در صنایع مختلف را تسهیل کند.